深色模式
模型与权限模式
Claude Code 启动后,有三样东西直接决定它怎么帮你干活:权限模式(它动手前问不问你)、模型(用哪个"大脑")、努力程度(这个大脑思考得多深)。
权限模式:它动手前,问不问你
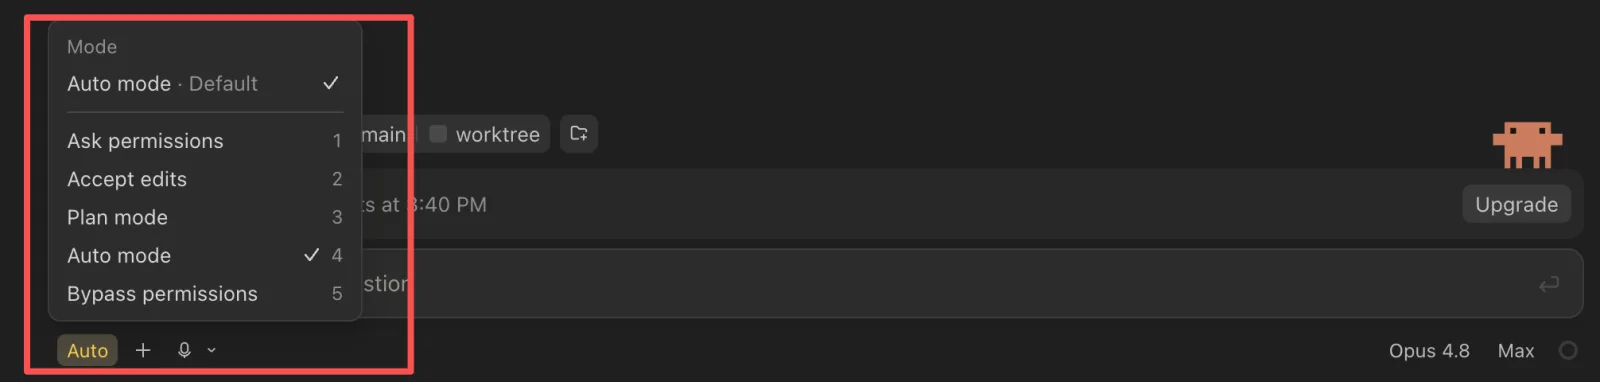
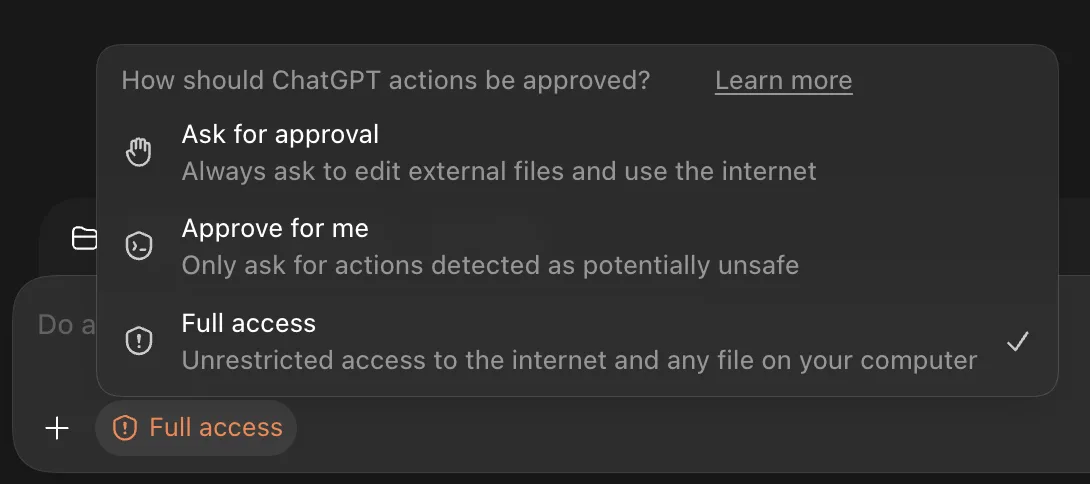
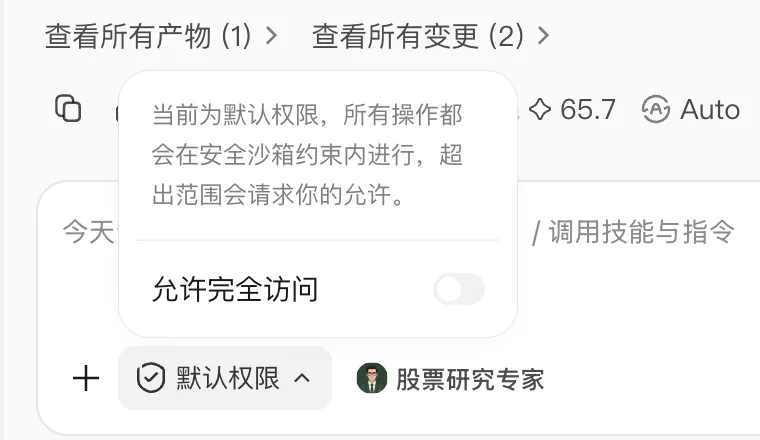
权限模式管的是一道"安全阀"——Claude Code 在改文件、跑命令之前,要不要先征得你同意。按 Shift + Tab 键,就能在几种模式之间循环切换,当前处于哪种会显示在输入框下方。从"每一步都问"到"完全放手",越往后越省事,也越需要你信任它。常见的有下面这几档。
| Claude的权限模式 | ChatGPT(原Codex)的权限模式 | WorkBuddy的权限模式 |
 |  |  |
| 模式 | 它会怎么做 | 适合什么时候 |
|---|---|---|
| 询问许可(Ask permissions) | 每次改文件、跑命令前都停下来,等你点批准 | 刚上手,或做重要、不可逆的操作时,最稳妥 |
| 接受编辑(Accept edits) | 自动批准改文件,但执行命令等动作仍会先问你 | 已信任它改内容,又想对"跑命令"留一道关卡 |
| 计划模式(Plan mode) | 只查看、只思考、只出方案,绝不动手改任何东西 | 想先让它把思路和方案讲清楚,你点头后再执行 |
| 自动模式(Auto mode) | 大部分操作自动执行,只在少数敏感动作上停下确认 | 日常放手干活的常用挡,效率与安全比较平衡 通过API中站转接入的Claude不提供AutoMode能力,可以考虑使用Bypass permissions替代。 |
| 绕过许可(Bypass permissions) | 什么都不问,一路做到底 | 风险最高,只在你完全清楚后果、环境隔离时才用 |
模型:挑一个"大脑",在聪明、快慢、花费之间取舍
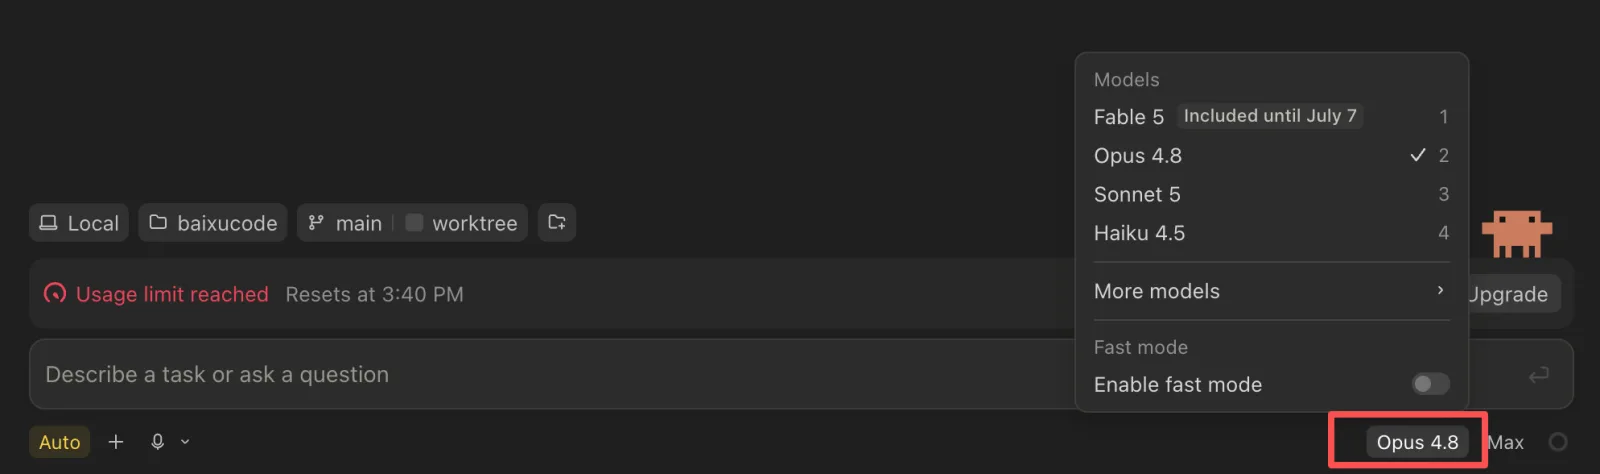
模型就是智能体背后干活的"大脑",用 /model 命令随时切换。不同模型在"聪明程度、响应速度、使用成本"上各有侧重——通常越聪明的越慢、也越贵。
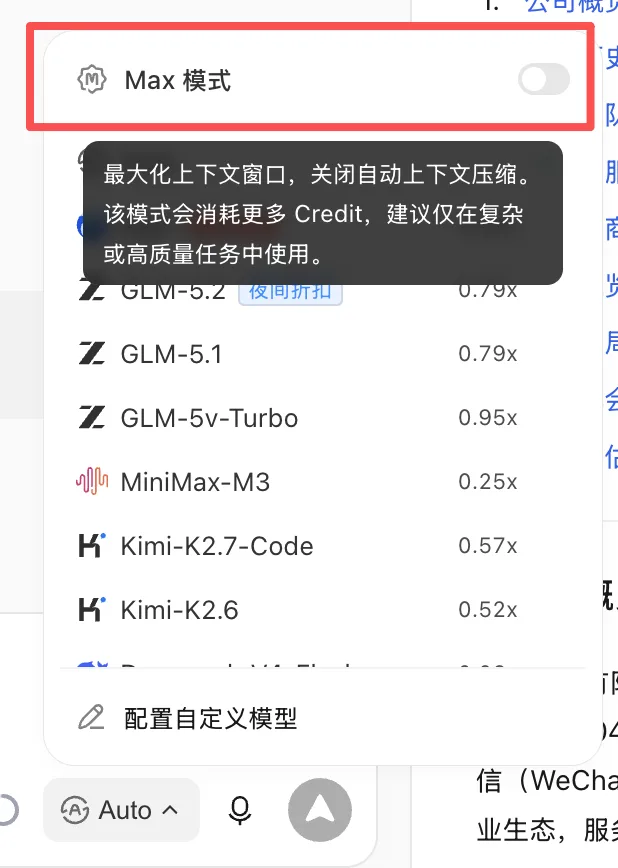
| Claude提供的模型 | ChatGPT(原Codex)提供的模型 | WorkBuddy提供的模型 |
 | 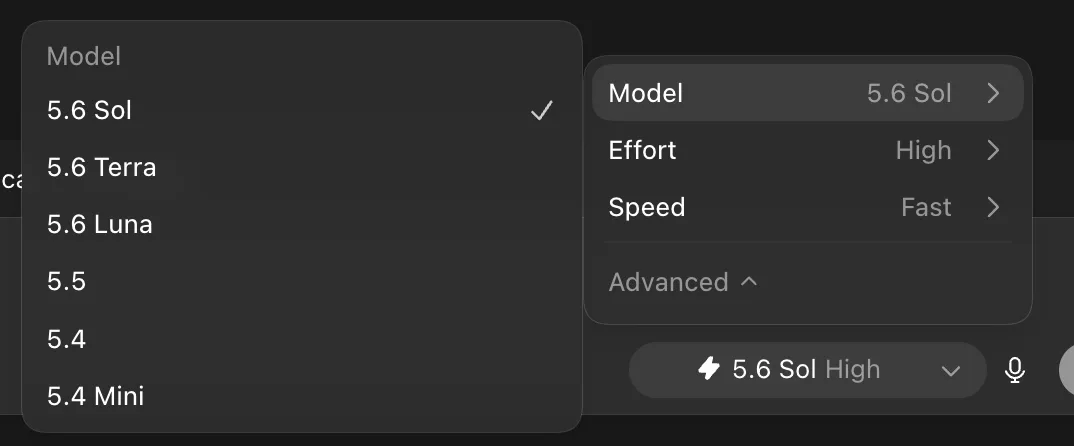 | 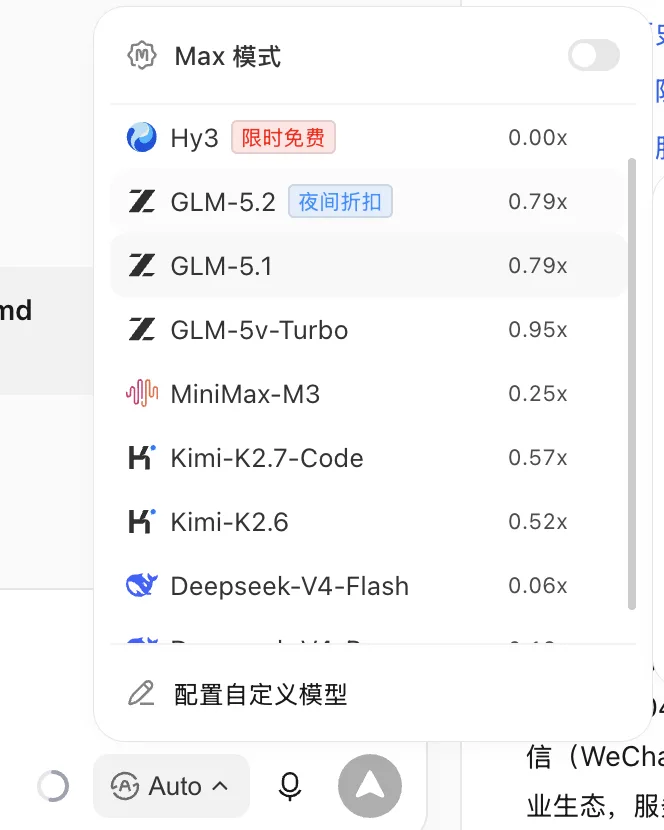 |
| 模型 | 特点 | 适合 |
|---|---|---|
| Fable 5 | Claude 当前最强的通用模型,擅长超长任务、复杂编程和专业知识工作,会主动规划、检查并修正自己的产出;能力最强,但消耗也最高 | 大型代码迁移、深度研究、跨多阶段的复杂项目,以及需要尽量少人工盯守的长任务 |
| Opus 4.8 | 仅次于 Fable 的成熟旗舰,复杂推理、编程、工具调用和长时间执行都很稳,还可打开快速模式提速 | 硬骨头难题、方案设计、复杂调试和高质量专业交付;Fable 不可用时的首选 |
| Sonnet 5 | 能力已接近 Opus,但速度和成本更均衡,尤其擅长日常编程、工具使用和多步骤执行 | 日常绝大多数任务的主力档,既要质量又不想把消耗拉满 |
| Haiku 4.5 | Claude 家族里最快、最省的轻量模型,简单编程和电脑操作也够用 | 批量整理、快速问答、简单改写和对响应速度敏感的轻活 |
| GPT-5.6 Sol | GPT-5.6 家族的旗舰,复杂推理、编程和专业知识工作最强,支持超长上下文与更高努力程度;质量最高,消耗也最大 | 架构设计、棘手调试、大型代码库、研究分析,以及需要模型持续自主推进的复杂任务 |
| GPT-5.6 Terra | 能力、速度和成本最均衡,价格更低但整体能力仍可与上一代 GPT-5.5 竞争 | 日常主力档;写代码、做文档、分析数据和操作电脑都适合从它开始 |
| GPT-5.6 Luna | GPT-5.6 家族里最快、最省的一档,保留新一代基础能力,但不追求极限推理 | 批量任务、简单修改、快速问答和对成本或延迟敏感的工作 |
| GPT-5.5 | 上一代旗舰,编程、研究、文档和电脑操作仍然很强,只是综合效率已被 5.6 系列取代 | 需要兼容旧工作流,或 5.6 暂不可用时继续使用 |
| GPT-5.4 | 较早的全能型号,推理、编程和原生电脑操作能力完整,但复杂任务表现不如新一代 | 已有稳定流程、一般难度的编码与办公任务 |
| GPT-5.4 Mini | 5.4 的轻量版,速度更快、消耗更低,擅长编码、电脑操作和子任务执行 | 大量重复任务、简单子任务和追求吞吐量的场景 |
| Hy3 | 腾讯混元的新一代开源模型,融合快思考与慢思考,复杂推理、指令遵循、编程和智能体执行都有明显提升;目前在 WorkBuddy 中限时免费 | 想低成本体验较强综合能力时优先尝试,尤其适合办公执行、资料整理和一般编程任务 |
| GLM-5.2 | 智谱最新旗舰,主打百万级上下文、长时间自主执行和高级编程,可调努力程度;属于当前开源模型第一梯队 | 大型代码库、长链路任务、复杂工程优化和需要持续推进的高难度工作 |
| GLM-5.1 | 上一代旗舰,长任务和编程能力成熟稳定,但上下文与上限不如 5.2 | 一般复杂度的开发、研究和多步骤任务;不必追新的稳定选择 |
| GLM-5V-Turbo | 面向视觉编程的多模态模型,能看懂截图、界面和图表,再结合代码完成任务 | 前端还原、看图改页面、视觉调试,以及需要同时理解图片与代码的工作 |
| MiniMax-M3 | 兼具百万级上下文、原生多模态、编程与智能体能力的开源旗舰,长任务能力强,当前倍率也较低,性价比突出 | 长文档、大型仓库、看图执行和预算敏感的复杂任务 |
| Kimi-K2.7-Code | 专门面向智能体编程的开源模型,强调长时间写代码、调用工具和完成完整工程任务 | 代码库级修改、持续调试、重构和从需求到可运行产品的开发任务 |
| Kimi-K2.6 | Kimi 的通用多模态旗舰,编程、视觉理解、长任务和多智能体协作都较强,比 Code 版更全能 | 研究、内容与产品制作、看图分析,以及编程和办公混合任务 |
| DeepSeek-V4-Flash | DeepSeek V4 的快速低成本版本,兼顾普通推理、编程和长上下文,突出速度与性价比 | 高频日常任务、批量处理和预算优先的场景;极复杂长任务优先选上面的旗舰型号 |
努力程度:同一个大脑,思考得多深
| Claude的努力程度 | ChatGPT(原Codex)的努力程度 | WorkBuddy的努力程度 |
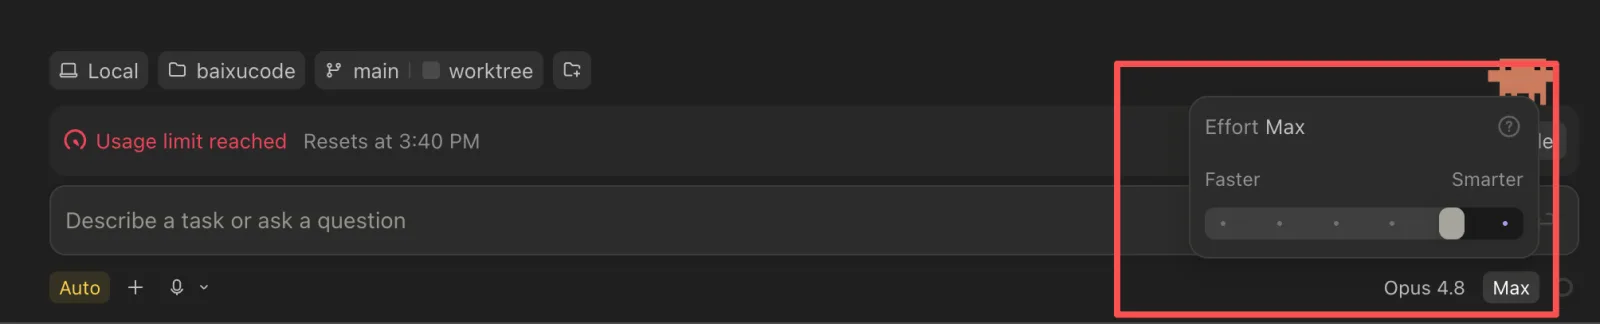 | 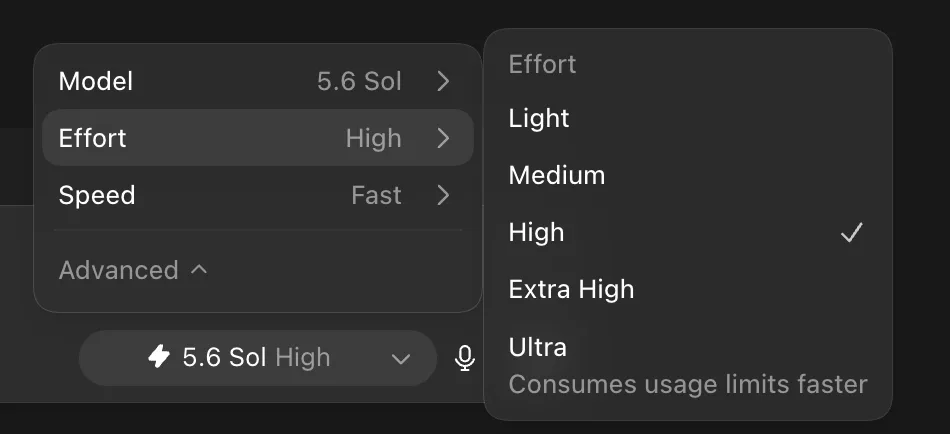 |  |
选好模型,还能再调它的"努力程度"(也叫思考程度)。同一个大脑,你可以让它"想快一点"或"想深一点"——就像人既能脱口而出,也能闭眼琢磨半天再开口。菜单里是一根从"更快(Faster)"滑到"更聪明(Smarter)"的滑杆,一般分几挡:越往"聪明"端,思考越充分,也越慢、越费。简单活儿用低挡,够快够省;真遇到难题就往高挡拉,让它多想想,结果更靠谱。
💡
三者怎么搭:新手起步,权限模式先用"询问许可"或"计划模式"多观察,模型选 Sonnet,努力程度居中——既安全又够用。熟练之后再按活儿调:重要难题上 Opus、配高努力程度;日常杂事用 Sonnet/Haiku 加自动模式,提速又省钱。